Ну чё, малютки, этот пост для тех, кто каждый день гоняет ChatGPT или Claude, но так и не понял, что там внутри происходит. Ты пишешь «Какая столица Франции?», модель отвечает «Париж». Между вопросом и ответом нет никакой базы знаний и никакого поиска. Модель раз за разом решает одну и ту же задачу: какой токен следующий.
В блоге уже есть глубокие разборы почти каждого шага: токенизация, RoPE, KV-кэш, FlashAttention, MoE, сэмплинг. Здесь я собираю их в одну картинку и на каждом шаге оставляю ссылку, куда копать дальше. Чтобы не было голой теории, я прогнал маленькую открытую модель Qwen3-0.6B у себя на CPU, и все числа ниже — её настоящие.
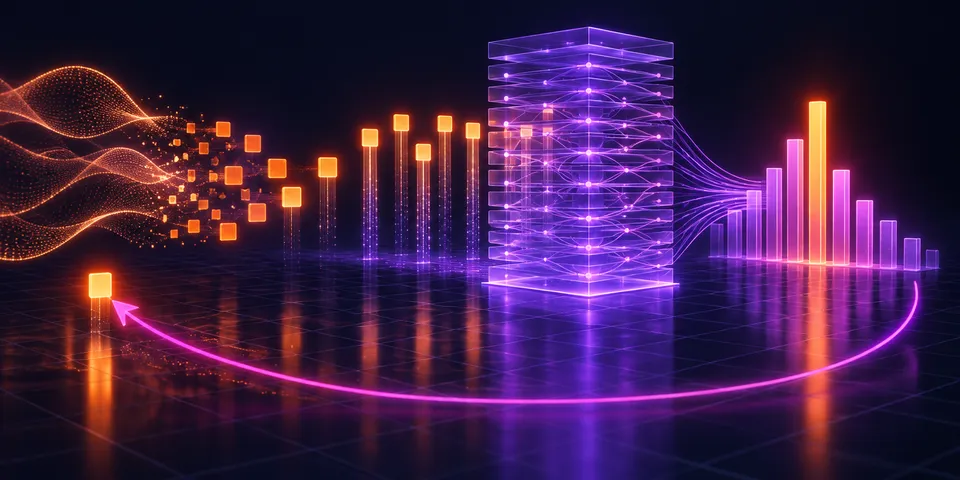
Текст режется на токены, каждый токен превращается в вектор. Векторы проходят через 28 слоёв: в каждом токены смотрят друг на друга (attention) и обрабатываются по отдельности (MLP). Вектор последнего токена превращается в оценку для каждого из 151 936 токенов словаря, softmax делает из них вероятности, и один токен выбирается. Его дописывают в конец, и всё повторяется, пока модель не выдаст токен «я закончила».
Qwen3-0.6B: 28 слоёв, вектор на 1024 числа, словарь на 151 936 позиций. Контекст 32 768 токенов.
Обычная LLM за проход выдаёт ровно один следующий токен. Ответ на сто токенов — это сто проходов подряд.
Покрути сам
Сначала демка, потом разбор по шагам. Выбери промпт и пройди все шесть шагов:
Посмотри на разницу между вкладками. На английском «The capital of France is» модель отвечает « Paris» с вероятностью 65,7%. По-русски, без чата, лидер « это» с 13,5%, и модель уходит в рассуждения про население. А в режиме чата отвечает «Париж» — правда, собирает его из трёх токенов: «П», «ари», «ж». Откуда такая разница, станет понятно к концу статьи.
Шаг 1. Текст → токены
Модель получает на вход не буквы и не слова, а последовательность токенов: кусков текста из фиксированного словаря. Словарь собирают алгоритмом BPE: берут огромный корпус и раз за разом склеивают самые частые пары символов в новый кусок. Частые слова становятся одним токеном, редкие режутся на части.
У каждого токена есть номер (id). «The capital of France is» для Qwen3 — это пять чисел: 785, 6722, 315, 9625, 374. А «Столица Франции —» — уже восемь: «Ст», «ол», «и», «ца», « Ф», «ран», «ции», « —». Длинная фраза из демки по-русски заняла 24 токена, а её английский перевод — 18.
По замеру авторов T-pro 2.0, токенизатор Qwen3 тратит в среднем 3,12 токена на слово русской Википедии и 1,68 на слово английской. Русский выходит дороже и медленнее, подробно — в статье про токенизацию.
«strawberry» для Qwen3 — это три токена: str, aw, berry. Слово целиком модель видит как три числа, а не как десять букв. Поэтому «сколько букв r в strawberry» для многих моделей — неудобная задача. Неудобная, а не невозможная: исследования показывают, что буквы внутри токенов модели узнавать умеют, хуже у них с подсчётом.
Шаг 2. Токены → векторы
С номером токена считать нечего, поэтому первым делом модель меняет его на вектор — 1024 числа. У Qwen3-0.6B есть таблица на 151 936 строк по 1024 числа: по строке на каждый токен словаря. Это 155,6 млн параметров, четверть всей модели. Номер токена — просто номер строки, которую надо взять.
Эти векторы модель подобрала во время обучения. Их часто называют «координатами смысла», но это метафора: отдельным числам в векторе нельзя приписать понятное человеку значение. И пока что каждый вектор знает только, какой это токен, а о соседях — ничего.
Порядок токенов вектор тоже не знает. У старого GPT-2 к эмбеддингу прибавляли отдельный выученный вектор позиции. У Qwen3 и большинства современных моделей позиция кодируется иначе, поворотом векторов прямо внутри attention — это RoPE, о нём есть отдельная статья.
Шаг 3. 28 слоёв трансформера
Дальше векторы проходят через стек одинаковых по устройству слоёв. У Qwen3-0.6B их 28. Удобно представлять так: у каждого токена есть свой вектор, который едет через все слои, и каждый слой дописывает в него что-то своё. Этот вектор называют residual stream.
Внутри одного слоя Qwen3 два блока:
Нормализация (у Qwen3 это RMSNorm) держит числа в разумном масштабе, чтобы за 28 слоёв они не разъехались. После последнего слоя стоит ещё одна, финальная.
Что происходит внутри стопки, можно подсмотреть приёмом logit lens: взять вектор после слоя N и сразу превратить его в вероятности, как будто слоёв дальше нет. Открой в демке шаг 3. На английском промпте до 22-го слоя наверху мусор, а на 23-м резко всплывает « Paris». А в чате на русском на 23-м слое английский «Paris» набирает 84%, к выходу падает до 5%, а наверх выходит русское «П». Похоже, модель «думает» ближе к английскому и переводит в конце. Похожую картину Wendler и соавторы в 2024 году нашли у Llama-2. Но logit lens — грубый приём, промежуточные слои не учили выдавать ответ напрямую, так что это подсказка, а не точное «мнение» слоя.
Attention: кто на кого смотрит
Каждый токен делает из своего вектора три новых: запрос (Q) «что я ищу», ключ (K) «что у меня есть» и значение (V) «что я отдам». Запрос токена сравнивается с ключами всех предыдущих, из сравнения получаются веса, и токен забирает себе смесь их значений с этими весами:
Здесь — маска: она ставит на всё, что правее текущего токена. Токен может смотреть только назад, в будущее нельзя, потому что при генерации будущего ещё нет.
Таких «смотрелок» в слое несколько, они называются головами. У Qwen3-0.6B 16 голов на запросы и 8 на ключи и значения: две головы запросов делят одну пару K/V, это экономит память (GQA). Головы бывают очень разные. Вот три настоящие головы Qwen3-0.6B на одной фразе:
На «кот» здесь смотрят «он» (кто устал?) и «сел» (кто сел?), а «ковёр» и «потому что» — почти нет. Похоже, голова связывает слова с тем, к кому они относятся. Но это один пример, а не доказательство.
Первая голова на «он» смотрит на «кот», вторая почти всегда смотрит на предыдущий токен (похоже, так склеиваются куски одного слова), а третья сваливает всё внимание на первый токен. Это один пример, и большинство из 448 голов модели выглядят куда запутаннее. Как attention на самом деле считают на GPU, чтобы не утонуть в памяти, — в статье про FlashAttention.
MLP: обработка каждого токена
После attention каждый вектор отдельно проходит через MLP: расширяется с 1024 до 3072 чисел, проходит через нелинейность и сжимается обратно. У Qwen3 это SwiGLU — вариант с тремя матрицами вместо двух. Geva и соавторы в 2021 году показали, что MLP работает как память «ключ → значение»: определённые узоры во входе включают определённые «подсказки» для следующего токена.
MLP — самая большая часть модели. Я посчитал по конфигу:
| Компонент Qwen3-0.6B | Параметров | Доля |
|---|---|---|
| MLP (28 слоёв) | 264,2 млн | 44% |
| Attention (28 слоёв) | 176,2 млн | 30% |
| Эмбеддинги (общие с выходом) | 155,6 млн | 26% |
| Нормализации | 0,07 млн | ~0% |
| Всего | 596,0 млн |
У больших MoE-моделей вместо одного MLP стоят сотни «экспертов», и на каждый токен работают только несколько из них. Как это устроено — в статье про MoE.
Шаг 4. Последний вектор → оценки для всего словаря
После 28 слоёв у каждого токена промпта есть свой вектор, но для следующего токена нужен только последний. Он «впитал» всё, что было в промпте до него.
Этот вектор умножают на матрицу размером 1024 × 151 936 и получают 151 936 чисел — логитов, по одному на каждый токен словаря. У Qwen3-0.6B эта матрица — та же таблица эмбеддингов из шага 2: модель использует её дважды, на входе и на выходе. Логит — это сырая оценка: чем больше, тем сильнее модель «за» этот токен.
Шаг 5. Логиты → вероятности → один токен
Softmax превращает 151 936 логитов в вероятности, которые в сумме дают 100%. В демке видны топ-10. Обрати внимание, что даже вместе они не дотягивают до 100%: остальное размазано по длинному хвосту из ста пятидесяти тысяч токенов.
Дальше из этого распределения выбирают один токен. Можно всегда брать самый вероятный (greedy, так сделано в демке), а можно случайно с учётом вероятностей. Ручки temperature, top_p и min_p управляют тем, насколько смело модель берёт не самые вероятные токены. Поэтому на один и тот же вопрос она отвечает по-разному. Почему temperature=0.7 — карго-культ, а temperature=0 не гарантирует одинаковых ответов, — в статье про сэмплинг.
65,7% у « Paris» — это не «модель на 65,7% уверена, что столица Франции Париж». Это доля, с которой она поставила бы этот кусок текста следующим. Модель может быть очень уверена в неправильном ответе.
Шаг 6. И снова: цикл генерации
Выбранный токен дописывают в конец и прогоняют модель ещё раз, уже для следующего. И так, пока модель не выдаст специальный токен конца. У Qwen3 это <|im_end|> с номером 151645. Ещё генерацию останавливает лимит max_tokens или стоп-строка, которую ты задал.
Звучит так, будто на каждый токен модель заново пересчитывает весь текст. Это не так, тут есть два режима:
- Prefill. Весь промпт прогоняется за один проход, все токены сразу, параллельно. Отсюда первый токен ответа. Время до него называют TTFT (time to first token).
- Decode. Дальше каждый проход обрабатывает только один новый токен. Ключи и значения прошлых токенов уже посчитаны и лежат в KV-кэше, их не пересчитывают. Интервал между токенами называют ITL.
Поэтому длинный промпт замедляет начало ответа, а длинный ответ — всё остальное. Сколько памяти съедает KV-кэш и почему он главный пожиратель VRAM — в статье про KV-кэш. Как выдавать за проход не один токен, а несколько — в статье про спекулятивный декодинг. А модели, которые вообще не пишут слева направо, — в статье про diffusion LLM.
Откуда модель «знает», как отвечать
Всё, что выше, — механика. Но почему без чата модель по-русски понесла про население, а в чате ответила «Париж»?
Сначала модель предобучают: на триллионах токенов текста учат предсказывать следующий. После этого она отличный «продолжатель текста», но не собеседник. Именно это видно во вкладке «Сырой текст»: после « Paris» она сама себе придумывает следующую фразу про столицу Италии.
Потом идёт пост-тренинг: модель дообучают на диалогах и с обратной связью, чтобы она отвечала на вопросы, а не продолжала их. Подробно — в статье про RLHF, DPO и GRPO.
А чат — это тоже просто текст. Твоё сообщение заворачивается в шаблон:
<|im_start|>user
Какая столица Франции? Ответь одним словом.<|im_end|>
<|im_start|>assistant
<|im_start|> и <|im_end|> — специальные токены (151644 и 151645), а «user» и «assistant» — обычные слова. Модель на пост-тренинге научилась, что после assistant идёт ответ. У Qwen3 есть ещё режим размышлений: если его включить, первым токеном почти наверняка будет <think> (99,98% в моём прогоне), и до ответа модель сначала напишет свои рассуждения. Если нужен строго JSON на выходе, одного шаблона мало — смотри статью про structured outputs.
Масштабы: маленькая, средняя и огромная
| GPT-2 small (2019) | Qwen3-0.6B | Qwen3.5-397B-A17B | |
|---|---|---|---|
| Параметров | 124 млн | 596 млн | 397 млрд, из них 17 млрд активных |
| Словарь | 50 257 | 151 936 | 248 320 |
| Размер вектора | 768 | 1024 | 4096 |
| Слоёв | 12 | 28 | 60 |
| Головы attention (Q / KV) | 12 / 12 | 16 / 8 | 32 / 2 |
| MLP | обычный | SwiGLU | 512 экспертов, на токен 10 + 1 общий |
| Позиции | выученные векторы | RoPE | RoPE |
| Контекст | 1024 | 32 768 | 262 144 |
Шаги везде одни и те же. Отличаются масштаб и детали: у большой Qwen3.5 часть слоёв вообще использует не обычный attention, а линейный (Gated DeltaNet), и MLP заменён экспертами. Подробнее о ней — в разборе Qwen3.5.
- «Модель ищет ответ в базе». Нет, она генерирует его токен за токеном из того, что выучила. Если надо, чтобы она опиралась на твои документы, это отдельная система — RAG.
- «Модель сначала придумывает весь ответ, потом печатает». Обычная LLM выдаёт ответ по одному токену, и каждый следующий зависит от уже написанных.
- «temperature=0 — значит всегда одинаково». Почти, но нет: мешают батчи и арифметика GPU. Разбор — в статье про сэмплинг.
- «Слово = токен». «Париж» у Qwen3 — три токена, « Франции» — тоже три.
Куда читать дальше
Если хочешь пройти весь путь глубже, вот маршрут по блогу в порядке шагов:
TL;DR
- LLM за проход предсказывает один следующий токен. Ответ — это цикл таких проходов.
- Токены: текст режется на куски из словаря. «Столица Франции —» для Qwen3 — 8 токенов, «The capital of France is» — 5.
- Векторы: каждый токен меняют на 1024 числа из таблицы.
- 28 слоёв: attention (токены смотрят назад друг на друга) + MLP (каждый токен отдельно). MLP — 44% параметров.
- Логиты → softmax → вероятности по всем 151 936 токенам, выбираем один.
- Prefill обрабатывает промпт разом, decode — по токену, с KV-кэшем.
- Без пост-тренинга модель — «продолжатель текста». Чат — это тоже текст со спецтокенами.
Источники
- Qwen3-0.6B: config.json, карточка модели, tokenizer_config.json, generation_config.json
- Qwen3: реализация в Transformers
- GPT-2: config.json и исходный код OpenAI
- Qwen3.5-397B-A17B: карточка модели
- Vaswani et al., 2017. Attention Is All You Need
- Radford et al., 2019. Language Models are Unsupervised Multitask Learners (GPT-2)
- Sennrich et al., 2016. Neural Machine Translation of Rare Words with Subword Units (BPE)
- Su et al. RoFormer (RoPE)
- Zhang & Sennrich, 2019. RMSNorm
- Shazeer, 2020. GLU Variants Improve Transformer (SwiGLU)
- Ainslie et al., 2023. GQA
- Elhage et al., 2021. A Mathematical Framework for Transformer Circuits
- Wendler et al., 2024. Do Llamas Work in English? On the Latent Language of Multilingual Transformers
- Geva et al., 2021. Transformer Feed-Forward Layers Are Key-Value Memories
- vLLM: Inside vLLM (prefill и decode) и метрики TTFT/ITL
- Hugging Face: Chat templates
- T-pro 2.0 (EACL 2026): токенизация русского и английского
- Cosma et al., 2025. The Strawberry Problem и Fu et al., 2024. Why Do LLMs Struggle to Count Letters?
Похожие статьи
Почему ChatGPT пишет «delve» и виноват ли в этом RLHF 🕵️✍️
Слово delve в PubMed выросло в 30 раз за четыре года. Разбираем, как это измерили (метод избыточной лексики), каких подозреваемых проверили Juzek и Ward, при чём тут нигерийские разметчики, как маленький бонус от reward model раздувает одно слово — и что LLM-стиль делает с текстами людей.
Читать далее фундамент
Ручки сэмплинга: почему temperature=0.7 — это карго-культ 🎛🎲
Что на самом деле делают temperature, top-k, top-p и min-p с распределением вероятностей, в каком порядке они применяются (в vLLM и в HuggingFace он разный), что ставить под код, JSON и творчество — и почему temperature=0 всё равно не даёт детерминизма.
Читать далее